Product updates
•
20.09.2026
Machine-instellingen en procesdata samenbrengen (UNS)
In de meeste fabrieken staan machine-instellingen in Excel en procesdata in een aparte database. Niemand kan zien of een ingestelde waarde ook oplevert wat de bedoeling was. We bouwden het platform dat dat oplost en de architectuur erachter laat precies zien waarom "registreren" en "leren" twee verschillende dingen zijn.

Frits van der Geest
Het probleem: twee bronnen die nooit met elkaar praten
Een typisch productiebedrijf werkt met twee gescheiden informatiebronnen. Een lijst recepturen en machine-instellingen staat in Excel. Procesdata wordt vastgelegd in een aparte database. Tussen die twee zit geen koppeling.
Bij het wisselen van een productietype zoekt de operator de juiste instellingen op in Excel en voert die met de hand in op de machine. Loopt de batch daarna minder goed, dan is er geen manier om terug te kijken welke instellingen precies actief waren. De database legt wel de gemeten resultaten vast, maar niet de waarden die de operator had ingevoerd. Wie wil weten of een hogere of lagere instelling beter uitpakt, moet twee bronnen met de hand naast elkaar leggen en gokken welke regel bij welke batch hoorde. Bijsturen tijdens het draaien is zo lastig, en elke analyse achteraf begint met datzelfde handwerk.
Dit is exact het probleem dat we eerder beschreven in wat shop floor control de basis maakt van elke fabrieksverbetering: zonder een centrale plek weet niemand wat er daadwerkelijk gebeurde, alleen wat er gepland was.
De oplossing: één centrale plek voor machinedata
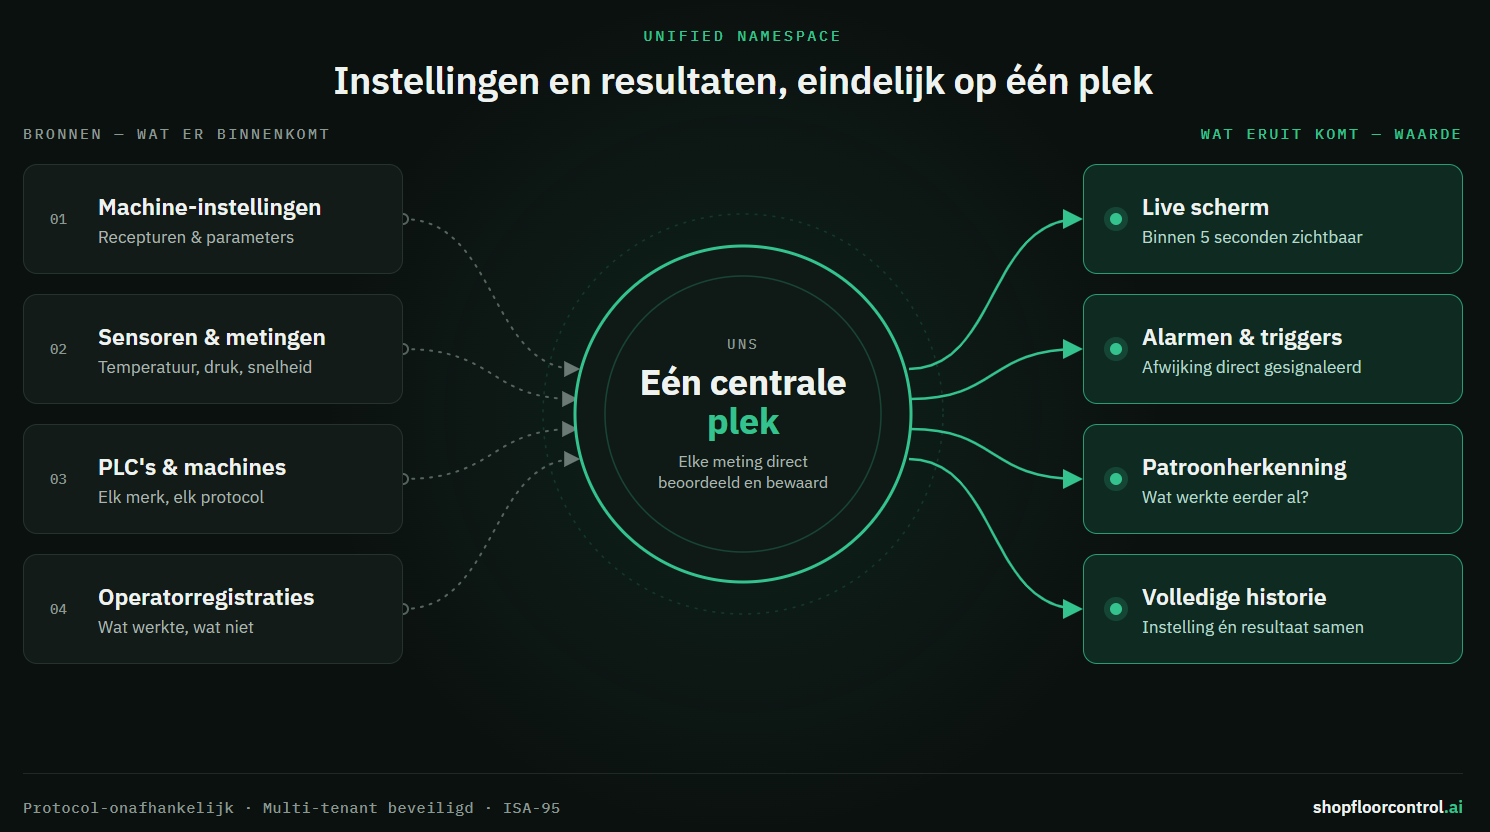
Bij Motivate bouwden we een Unified Namespace: een gestructureerde, centrale plek waar alle machine-instellingen en procesdata samenkomen. Geen losse extra applicatie, maar de verbinding die tot nu toe ontbrak.
De opbouw volgt ISA-95, de internationale norm die een productieomgeving modelleert van bedrijfsniveau tot het kleinste meetpunt op een machine. Een machine-uitlezing (temperatuur, druk, een instelwaarde) krijgt daarmee een vaste, voorspelbare plek in de structuur ongeacht welk merk machine of welke klant.
Drie ontwerpkeuzes maken dit platform bruikbaar bij elke volgende fabriek, niet alleen bij de eerste:
1) Elke machine kan meepraten, ongeacht het protocol. Machines spreken verschillende "talen". De koppeling is protocol-onafhankelijk gebouwd: een nieuw type machinecommunicatie komt erbij zonder de rest van het systeem aan te raken. Een nieuwe klant of een ander machinepark sluit aan zonder ingreep in de kern.
2) Elke meting wordt direct beoordeeld. Zodra een waarde binnenkomt, checkt het systeem die meteen tegen de ingestelde grenzen. Geen wachten tot een rapport aan het einde van de dag, een afwijking wordt binnen enkele seconden zichtbaar.
3) Klanten zijn volledig van elkaar gescheiden. Meerdere fabrieken kunnen op hetzelfde fundament draaien zonder dat gegevens ooit vermengd raken. Multi-tenant beveiliging zorgt dat elke klant alleen bij zijn eigen data kan, ook al draait de onderliggende techniek gedeeld.
De kernlogica is losgekoppeld van de buitenwereld. Dat klinkt technisch, maar het betekent iets simpels: het systeem is te testen en door te ontwikkelen zonder dat er een machine hoeft te draaien. Dat maakt het platform sneller uit te breiden en minder kwetsbaar voor fouten.
Waarom instellingen vastleggen niet hetzelfde is als ervan leren
Hier raakt dit project de kern van wat we bij shopfloorcontrol.ai al langer beweren: vastleggen is niet hetzelfde als leren. Een systeem dat alleen registreert, weet dát een instelling is gebruikt. Het weet niet of die instelling goed was. Dit platform gaat een stap verder: het slaat metingen niet alleen op, maar herkent ook patronen. Vergelijkbare situaties uit het verleden worden doorzoekbaar, zodat een operator kan navragen: is dit eerder voorgekomen, en wat werkte toen?
Dat is precies het onderscheid tussen shop floor control en een operational learning platform. Shop floor control registreert. Een lerend systeem herkent wat werkte en geeft die kennis terug op het moment dat het ertoe doet.
Wat er in de praktijk gebeurde
Het platform is opgeleverd in stappen, waarbij elke stap direct een werkende doorsnede van het hele systeem opleverde. Niet één onderdeel volledig af, terwijl de rest nog moest wachten. Dat bleek in de praktijk waardevol: bij elke stap was er iets concreets te laten zien en te testen, in plaats van pas na maanden een eerste werkend geheel.
Twee resultaten zijn direct aangetoond op een testopstelling met echte hardware:
- Een meting van de machine staat binnen vijf seconden op het scherm van de operator of manager
- Als de centrale verbinding tijdelijk wegvalt, gaat er niets verloren: berichten worden gebufferd en alsnog verwerkt zodra de verbinding terugkomt
Ook is gebleken dat het systeem volledig te testen is zonder dat er een echte machine of database nodig is. Dit is belangrijk voor de snelheid waarmee nieuwe functionaliteit daarna toegevoegd kan worden.
Wat dit betekent voor de volgende fabriek
De architectuur is bewust generiek: dezelfde kern werkt bij een volgende fabriek met ander machinepark, zonder dat er in de basis iets hoeft te veranderen. Alleen de klantspecifieke regels en instellingen, welk alarm bij welke afwijking, welke instelling bij welk product, komen apart binnen, via het instelscherm.
Zo is het bij een productiebedrijf in de maakindustrie ingezet: instellingen en resultaten die voorheen los van elkaar stonden, komen nu voor het eerst samen op één centrale plek.
Dat is dezelfde filosofie die achter shopfloorcontrol.ai zit: één fundament, en per fabriek precies de kennis en instellingen die daar horen.
Vraag aan jou:
Hoeveel tijd gaat er bij jullie verloren aan het met de hand naast elkaar leggen van instellingen en resultaten? En wanneer heb je voor het laatst met zekerheid kunnen zeggen welke instelling bij welke batch hoorde?